TorchNeuron y AWS Trainium ofrecen un entorno robusto para el perfilado de cargas de trabajo de IA, destacando el cambio hacia la cognición delegada en la optimización del rendimiento de IA.
La integración de TorchNeuron con AWS Trainium representa un avance significativo en la optimización de modelos de IA, proporcionando información sobre dónde se consume el tiempo de ejecución. La utilización de Trainium, un chip de IA diseñado específicamente, junto con TorchNeuron, un backend nativo de PyTorch, es fundamental para agilizar las operaciones de aprendizaje profundo.
Integración de TorchNeuron y PyTorch
El backend Neuron aprovecha los puntos de extensión de PyTorch, permitiendo una integración fluida sin claves de despacho adicionales como CUDA. Esta integración permite que el paquete TorchNeuronx funcione como un backend robusto para PyTorch, facilitando cargas de trabajo de IA optimizadas.
Comprendiendo el Profiler de Neuron
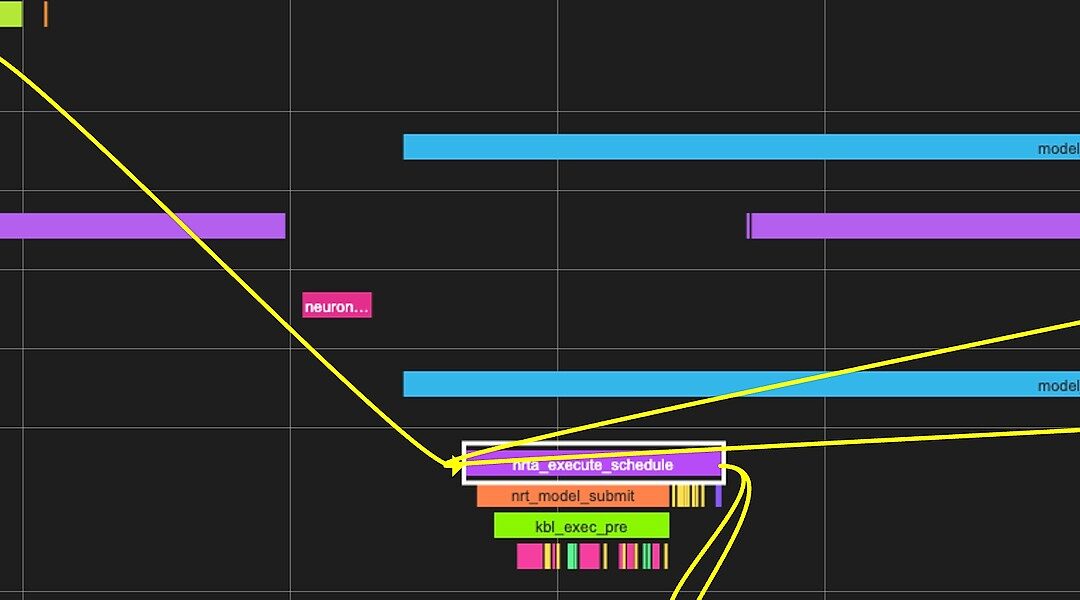
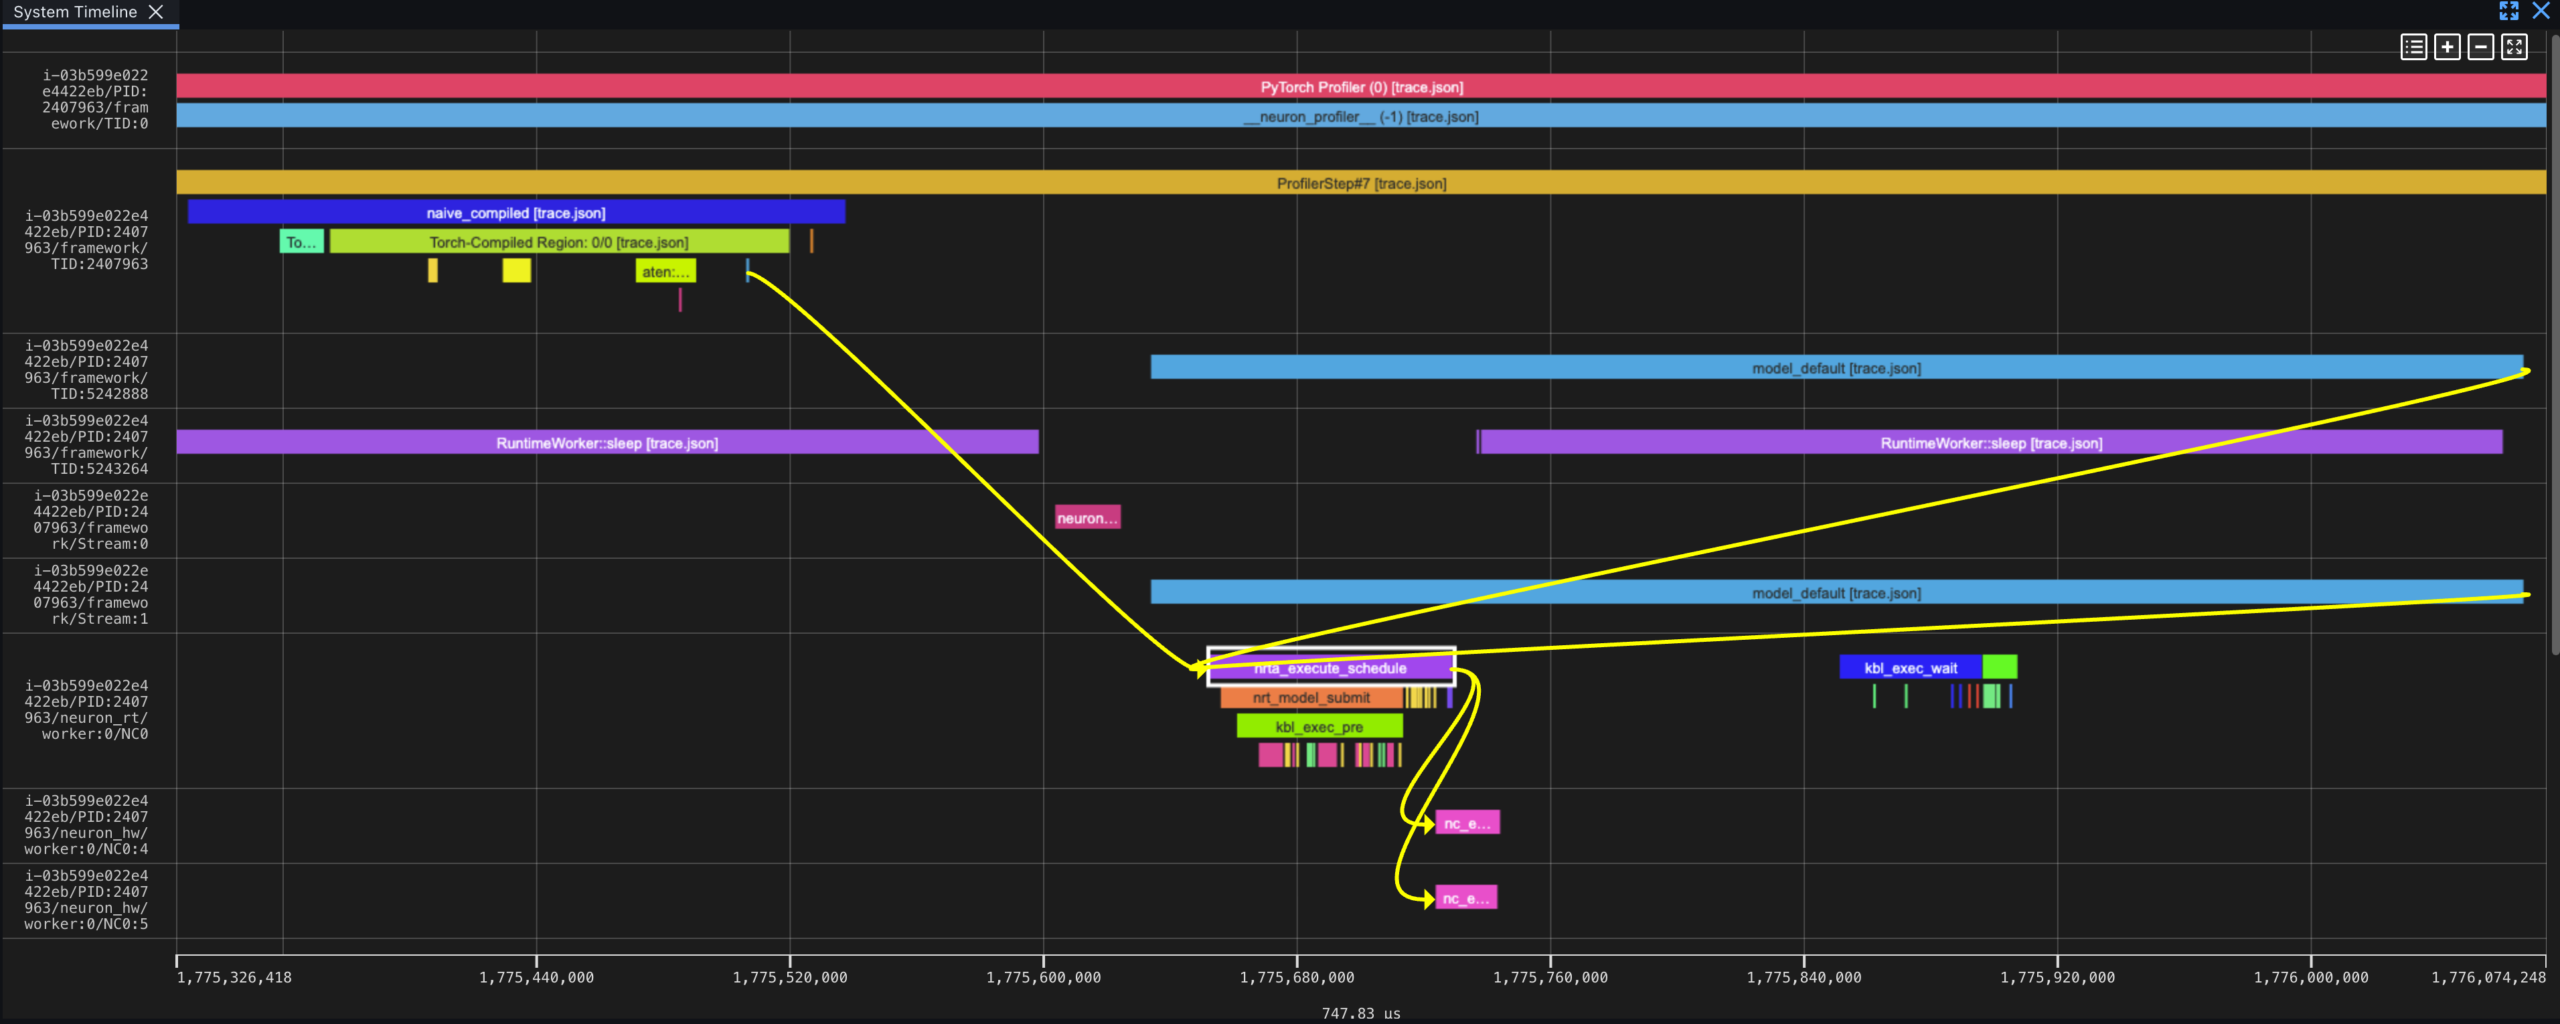
El proceso de perfilado comienza configurando torch.profiler utilizando NeuronConfig. Esta configuración rige los flujos de datos y NeuronCores, capturando trazas detalladas a través del NeuronProfiler. El resultado es una traza de sistema integral que facilita las comparaciones entre los tiempos de CPU y de dispositivo, crucial para identificar cuellos de botella en el rendimiento.
Utilizando Neuron Explorer
Neuron Explorer proporciona una interfaz basada en navegador para analizar trazas del sistema. Permite a los usuarios verificar datos numéricos de los promedios clave y obtener una comprensión más profunda de las operaciones entre las fases de despacho. Esta herramienta destaca cómo las operaciones individuales se traducen a través de los marcos, el tiempo de ejecución y las vías de hardware.
Perfilando la Operación RMSNorm
El perfilado de la operación RMSNorm en tres variaciones muestra los caminos distintos que toma cada implementación. El enfoque ingenuo, construido con operaciones individuales de PyTorch, refleja un camino de ejecución fragmentado. En contraste, el uso de torch.rms_norm() consolida la operación en un solo núcleo eficiente. Compilar con torch.compile mejora aún más esta eficiencia, optimizando el flujo de trabajo.
Cambio a Nivel de Sistema: Cognición Delegada
El proceso de perfilado en AWS Trainium es una manifestación de la cognición delegada, donde los sistemas de IA son encargados de funciones de toma de decisiones cada vez más complejas. Al automatizar el perfilado y la optimización de cargas de trabajo, los profesionales de IA pueden cambiar su enfoque de la afinación manual a tareas estratégicas de orden superior, mejorando la productividad y la innovación.
La importancia de este cambio no puede subestimarse. A medida que los sistemas de IA se vuelven más hábiles en la autooptimización, los roles humanos en estos procesos pasan a ser de supervisión y desarrollo estratégico, en lugar de intervención granular.
Al adoptar la cognición delegada, la comunidad de IA está allanando el camino para sistemas más inteligentes y autónomos capaces de auto-mejorarse, un paso crucial en la evolución de las tecnologías de IA.
La monitorización continúa.