La especialización del vocabulario en pequeños modelos de lenguaje puede reducir drásticamente los costos de inferencia en un 77%, con implicaciones significativas para la eficiencia de la IA.
El potencial del vocabulario especializado en modelos de lenguaje como Qwen y Gemma está transformando la eficiencia de las aplicaciones de IA. Un estudio reciente de Dharma-AI revela un método innovador que reduce los costos de inferencia en un sorprendente 77%. Este desarrollo tiene el potencial de impactar significativamente las velocidades de procesamiento y la rentabilidad de los modelos de IA en diversas aplicaciones.
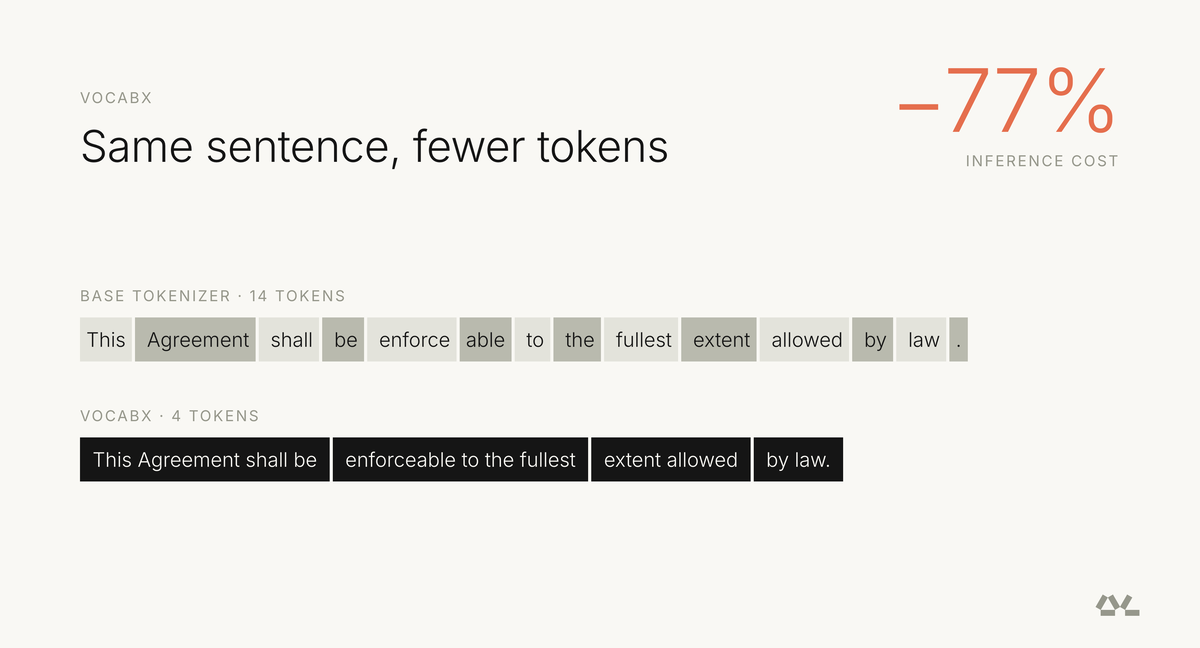
Tradicionalmente, el tokenizador en los modelos de IA es fijo, lo que lleva a ineficiencias cuando los modelos se aplican a dominios específicos. Esta naturaleza fija significa que el modelo procesa numerosos tokens innecesarios, inflando los requisitos computacionales. Al redefinir el vocabulario con un enfoque en el costo en lugar de la frecuencia, el enfoque VocabX de Dharma-AI ha demostrado cómo los modelos pueden volverse más eficientes sin alterar la arquitectura subyacente.
El desafío de la tokenización en IA
Modelos como Qwen3-4B, utilizados para tareas específicas como la evaluación de ensayos en portugués, suelen utilizar un vocabulario amplio diseñado para propósitos generales. Sin embargo, en aplicaciones específicas de dominio, esto resulta en fragmentación y exceso. Por ejemplo, elementos repetitivos como sobres JSON o cláusulas estándar se dividen innecesariamente en múltiples tokens, mientras que el modelo procesa simultáneamente miles de entradas de vocabulario no utilizadas.
Este vocabulario generalizado exige que cada token generado sea evaluado contra un léxico grande, mayormente irrelevante, lo que añade carga computacional. En aplicaciones de ejemplo, como la evaluación de ensayos, el modelo desperdicia recursos calculando probabilidades para tokens que nunca utiliza.
VocabX: Una solución a las ineficiencias del vocabulario
La metodología VocabX aborda estas ineficiencias rediseñando cómo se especializa el vocabulario. En lugar de simplemente reducir el número total de tokens, VocabX evalúa cada token por su costo computacional, priorizando reducciones donde los ahorros son más impactantes.
VocabX trabaja en múltiples capas: replantea cómo se dividen las palabras en sub-palabras e identifica frases o secuencias de uso frecuente para convertirlas en tokens singulares y rentables. Esta optimización de doble capa reduce significativamente el recuento de tokens y la carga computacional.
El estudio mostró que “un token ahorrado en la respuesta del modelo vale 7.4 veces un token ahorrado en la entrada”, subrayando el valor estratégico de la optimización del vocabulario dirigido.
Patrón detectado
Este enfoque encarna un patrón de compresión de flujo de trabajo, donde los procesos se optimizan para minimizar el desperdicio de recursos y mejorar la eficiencia de costos. Al reducir el volumen y la complejidad del procesamiento de tokens, VocabX ejemplifica cómo la optimización enfocada puede llevar a mejoras sustanciales en el rendimiento del modelo y los costos operativos.
Estos aumentos de eficiencia son críticos, ya que se traducen en tiempos de procesamiento más rápidos y gastos reducidos, especialmente en entornos que requieren toma de decisiones rápida y despliegue de tecnologías de IA.
Implicaciones para el desarrollo de IA
Las implicaciones de esta investigación van más allá de los ahorros de costos inmediatos. Los vocabularios especializados podrían redefinir las mejores prácticas en el entrenamiento de IA, provocando un cambio hacia diseños de modelos más adaptables y rentables. A medida que la IA continúa permeando diversas aplicaciones industriales, la capacidad de optimizar el rendimiento del modelo sin comprometer la versatilidad de las arquitecturas subyacentes es un avance significativo.
A medida que crece la demanda de soluciones de IA, particularmente en sectores que exigen toma de decisiones rápida y precisa, innovaciones como VocabX pueden resultar fundamentales. No solo alivian la carga mecánica sobre los modelos, sino que también mejoran la experiencia del usuario a través de una entrega más rápida de resultados.
El monitoreo continúa mientras Dharma-AI finaliza su documento sobre VocabX, que promete más información sobre técnicas de especialización de vocabulario. Los avances reportados hasta ahora marcan un paso prometedor hacia sistemas de IA más eficientes, estableciendo un referente para futuros desarrollos en la optimización de modelos de IA.